为什么 Figma 把 AI 重做了一遍:看大厂的模型策略转向
Figma 把 AI 做了一遍"重做"——从早期那个什么都想做、什么都浅的聊天助手,收敛成嵌在设计流程里的几个具体动作。这不是产品经理的审美偏好,而是整个行业在付出学费之后学到的同一课。
AI 工具实测 · 产品深度观察 · 帮你避开每一个坑
Figma 把 AI 做了一遍"重做"——从早期那个什么都想做、什么都浅的聊天助手,收敛成嵌在设计流程里的几个具体动作。这不是产品经理的审美偏好,而是整个行业在付出学费之后学到的同一课。
我们把 10 款主流国产 AI 工具放在三套真实任务里跑了一遍:一份 200 页的招股书提炼、一个前端页面的从零实现、一组客服话术的批量改写。结果和"哪个模型跑分高"的直觉不太一样——能真正放进日常工作流的只有 4 款。
一、先说个场景 你打开 Telegram,给 OpenClaw 发了一句"帮我看一下今天有没有需要跟进的邮件"。几秒后,它把未读邮件的主题、发件人和简要摘要列了出来,并建议你下午三点前回复那封来自合作方的合同邮件。随后你又补了一句"顺便把回
Notion AI 上线满一年。这一年的迭代速度、定价变化、以及团队里真实的留存数据,我们做了一次完整复盘。结论是:它对团队仍有价值,但个人用户单独买这个附加包,大概率是笔亏本生意。
我们用同一个真实项目分别跑了 ChatGPT、Claude、Gemini 三家头部 AI 助手,从代码质量、上下文稳定性、长文档理解、中文表达、生态工具五个维度…
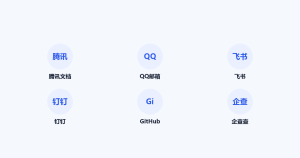
连上之后,AI 能自己翻邮箱、查文档、拉看板,不用你搬运数据。
拍一张表格发给豆包,让它"把数据整理成 Excel"。它回了一份整整齐齐的表格——但你要是拿去跟原件对一遍,往往会发现:某几行错位、某几个数字对不上、合并单元格全乱了。
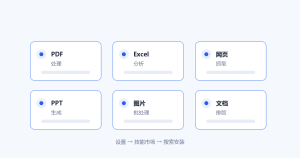
大模型有个广为人知的毛病:能推导微积分,却算不对 17 × 24。豆包在这方面的表现其实已经比早期模型好很多——它会在需要时调用计算工具。但"会算"和"算得对"之间,仍然隔着好几个坑。
 糖糖的测评笔记
 实用小程序测评
 老张的测评笔记
 老周的工具笔记
 小陈亲测推荐
 小马实测分享