用 DeepSeek API 做点正经事,迟早会撞上墙。尤其晚上、周末、或者某个爆款应用上线那天,请求突然开始失败,控制台里一片 429 Too Many Requests。阿文带团队跑批量任务时没少被它教做人,这篇把限流的「表现—原理—应对」一次讲清,重点给你能直接抄的指数退避代码和错峰思路。限流不是 DeepSeek 的缺陷,而是所有共享大模型服务的常态,会用的人把它当节奏器。
一、限流长什么样
限流不是「服务器挂了」,而是服务端在说「你太快了,先排队」。常见三种表现,严重程度递增:
- 直接 429:HTTP 状态码 429,响应体通常带一句限流提示。这是最礼貌的——它明确告诉你「被限了」,你只需退避重试。
- 响应变慢但不报错:没到硬上限,但队列排队,原本 2 秒的回答拖到 20 秒。这种最隐蔽,容易被误判成「模型变笨了」或「网络卡了」,其实只是前面排了队。
- 连接被重置 / 超时:极端高峰期,连接层直接断,连 429 都没给你,表现像网络故障。最难排查,因为错误信息和真故障一模一样。
区分「限流」和「真故障」:限流通常有规律(并发一高就出,闲时就好),且响应里有 429 或明确限流文案;真故障是全面瘫痪、连最简单请求都失败、且持续很久。先打一条最小请求探一下,能通就是限流,全不通再看是不是账号或全局问题。
二、限流的单位是什么
DeepSeek 的限流一般按令牌(token)和请求数(RPM / TPM)两个维度算。RPM 是每分钟请求数,TPM 是每分钟 token 数,任一个触顶都会 429。具体阈值(每分钟多少请求、多少 token)以官方文档当前版本为准,不同套餐、不同模型档位可能不同,reasoner 通常比 chat 更紧。
关键认知:限流看你「发多快」,不看你「发多少总量」。你一分钟发 100 个请求可能被限,但把 100 个摊到 10 分钟发,往往就稳了。所以应对核心就两条:被限了要会退避重试,平时要会错峰降速。总量不变,节奏对了就不撞墙。
三、指数退避:被拒后怎么重试
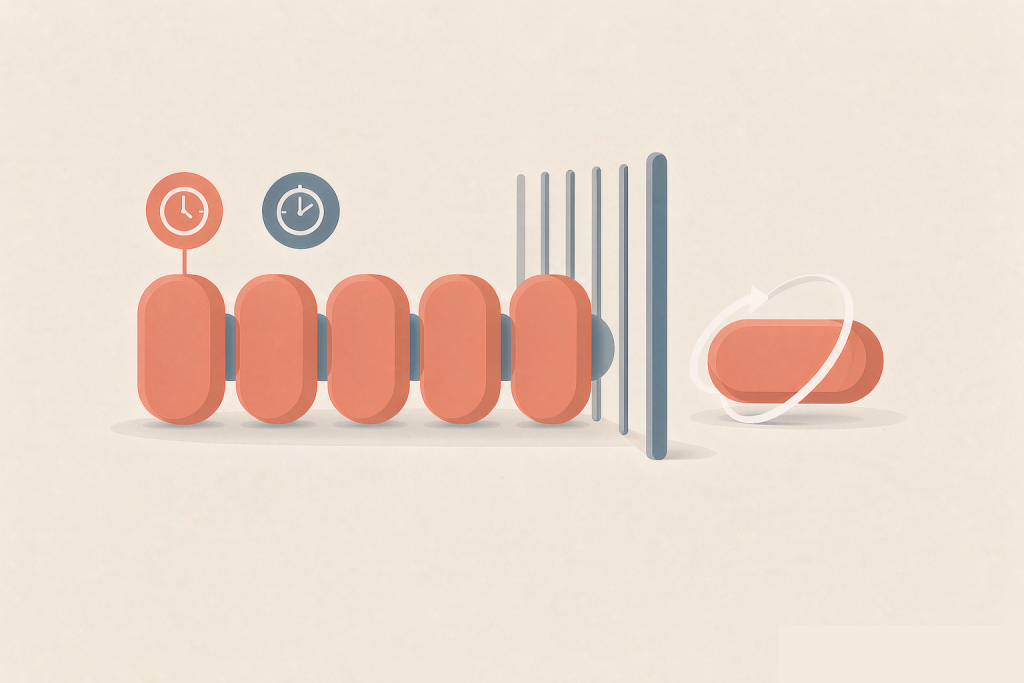
最简单的错误做法:429 了立刻重试,结果又被限,死循环烧光配额和时间。正确做法是指数退避 + 抖动——每次失败后等更久再试,并加随机扰动避免「一群请求同时苏醒」再次打爆服务端。
基础版:固定倍数退避
import time
import openai

client = openai.OpenAI(api_key="你的KEY", base_url="https://api.deepseek.com")

def call_with_retry(messages, max_retries=5):
    wait = 1  # 初始等待 1 秒
    for i in range(max_retries):
        try:
            return client.chat.completions.create(
                model="deepseek-chat", messages=messages
            )
        except openai.RateLimitError:
            if i == max_retries - 1:
                raise
            time.sleep(wait)
            wait *= 2  # 1, 2, 4, 8, 16 秒递增
进阶版:读 Retry-After 头 + 抖动
规范的服务端会在 429 响应里带 Retry-After 头,告诉你「至少等几秒」。优先听它的,比自己瞎猜准:
import random, time
from openai import OpenAI

client = OpenAI(api_key="你的KEY", base_url="https://api.deepseek.com")

def smart_retry(messages, max_retries=6):
    for attempt in range(max_retries):
        try:
            return client.chat.completions.create(
                model="deepseek-chat", messages=messages
            )
        except openai.RateLimitError as e:
            if attempt == max_retries - 1:
                raise
            # 尽量读服务端建议的等待时间
            resp = getattr(e, "response", None)
            retry_after = resp.headers.get("Retry-After") if resp else None
            if retry_after and str(retry_after).isdigit():
                base = int(retry_after)
            else:
                base = 2 ** attempt  # 指数兜底
            jitter = random.uniform(0, base * 0.3)  # 抖动防共振
time.sleep(base + jitter)为什么要抖动:如果 100 个失败请求都按「1,2,4,8」同步退避,它们会在同一秒集体重试,再次把服务端打爆,然后又一起 429,形成惊群效应。加随机抖动让它们错开苏醒,是分布式调用的基本修养。这点看似小事,批量任务里能决定你是平稳跑完还是雪崩。
退避上限与总超时
无限退避也不行。建议设一个最大等待(如 60 秒)和总超时(如 5 分钟),超过就放弃这条并记入失败队列,后面统一补救。否则一条卡住会拖垮整个批次的进度。
四、批量任务怎么错峰
单条重试解决「偶发限流」,但你要跑十万条数据,光靠重试不够,得从源头降速、错峰。
1. 信号量限并发
别用线程池无脑拉满。用信号量把并发卡在阈值以下,从源头不触发限流:
import asyncio, random

semaphore = asyncio.Semaphore(5)  # 同时最多 5 个

async def one_task(item):
    async with semaphore:
        return await call_api(item)
2. 令牌桶限速
更平滑的做法是令牌桶:按官方 RPM/TPM 阈值,匀速放请求。可用 token-bucket 思路自己实现,或引入现成限流库(如 ratelimit)。目标是让发送曲线贴合限额,而不是「猛冲—被限—退避—再猛冲」的锯齿。令牌桶还能按「已用 token 数」动态限速,比单纯限请求数更贴近真实限额。
3. 错峰时段选择
阿文实测(仅供参考,以你自己的监控为准):国内工作日晚 8–11 点、周末全天最易拥堵;凌晨到早上相对空闲。非实时批量任务尽量排到闲时跑。给调度器加个「只在低峰窗口执行」的判断,能省掉一大半重试,整体耗时反而更短。
4. 任务分片 + 断点续跑
十万条别一次性提交。按 1000 条一个分片,每片记录进度到本地文件。被限流或中断后,从断点继续,而不是从头再来——既省配额,也避免重复调用产生费用。断点续跑还能让你在高峰期手动暂停、闲时恢复。
import json

def load_progress(path):
    try:
        return json.load(open(path))
    except FileNotFoundError:
        return {"done": 0}

# 每完成一片就写回 done 指针,崩溃也不怕
五、被限流时的降级策略
生产系统不能因为限流就全挂。准备几层兜底,让限流从「事故」变成「可接受的降级」:
- 换模型:
deepseek-reasoner限得严时,非关键路径切回deepseek-chat先顶着,保住可用性。 - 本地缓存:相同输入(比如常见 FAQ、固定查询)缓存上次结果,限流时直接返回缓存,用户无感。
- 队列化:把请求丢进消息队列(如 Redis / RabbitMQ),由消费者按限速慢慢消费,前端先返回「处理中」,后端异步补结果。
- 多 Key 轮询:额度按 Key 算时,准备多个 Key 做负载均衡(注意合规与套餐规则,别违反服务条款)。
- 优雅降级文案:实在不行,返回「服务繁忙,已为你排队,稍后通知」,比直接报错体验好。
六、监控与预警
别等用户投诉才发现被限。在调用层埋点:记录 429 次数、平均等待、重试成功率。当 429 比例超过阈值(比如 5%)就告警,提示你该降速或错峰了。阿文的做法是批量任务跑之前先看一眼过去一小时的 429 趋势,再决定并发数。数据驱动,比凭感觉稳。
六之一:熔断机制:别在泥潭里越陷越深
指数退避解决单条重试,但如果是全局持续限流(比如服务真扛不住了),还傻重试只会堆更多失败请求、拉长恢复时间。这时该上熔断:当失败率超过阈值,直接暂停一段时间所有请求,给服务端喘息,也保护自己的资源。
class CircuitBreaker:
    def __init__(self, failure_threshold=10, reset_seconds=60):
        self.failures = 0
        self.threshold = failure_threshold
        self.reset_after = reset_seconds
        self.opened_at = None

    def allow(self):
        if self.opened_at is None:
            return True
        import time
        if time.time() - self.opened_at > self.reset_seconds:
            self.failures = 0
            self.opened_at = None
            return True
        return False

    def record_failure(self):
        self.failures += 1
        if self.failures >= self.threshold:
            import time
            self.opened_at = time.time()
熔断打开期间,新请求直接走降级(返回缓存或排队),而不是冲上去送死。等冷却时间过了再半开试探,成功就恢复,失败继续熔断。这是把「限流应对」从战术升级到战略。
六之二:一个真实翻车案例
阿文团队曾有一次深夜跑十万条摘要,没做限速,开局就拉满 50 并发。结果前两千条还好,之后全线 429,退避重试又叠加上限,整个批次卡了半小时没进展,还白白消耗了配额。后来改成令牌桶限速 + 错峰到凌晨,同样的量两小时平稳跑完,重试次数不到十次。教训很朴素:别跟限流硬刚,顺着它的节奏走,反而最快。
六之三:把重试逻辑封装成装饰器
为了不每次手写 try/except,建议把退避重试封装成一个装饰器,所有调用统一套用:
import time, random, functools

def retry_on_limit(max_retries=5):
    def decorator(fn):
        @functools.wraps(fn)
        def wrapper(*a, **k):
            wait = 1
            for i in range(max_retries):
                try:
                    return fn(*a, **k)
                except Exception as e:
                    if i == max_retries - 1:
                        raise
                    if "429" not in str(e):
                        raise
                    time.sleep(wait + random.uniform(0, wait * 0.3))
                    wait *= 2
            return None
        return wrapper
    return decorator
这样业务代码只管调用,限流细节全收口在一处,维护和调参都方便。
从成本维度看限流: 限流虽然烦,但也是保护你钱包的机制——它逼你降速,避免一时冲动把整月额度几分钟烧光。配合用量监控,限流反而帮你养成「匀速、可控、可观测」的调用习惯。把限流当成系统的呼吸节奏,而不是敌人,心态会平和很多,方案也更稳。
最后提醒: 本文的退避系数、阈值、并发数都是示例,真实值请对照官方当前限额和你的监控数据来定。没有放之四海皆准的参数,只有持续观测、持续调优的节奏。
七、一个实战排查清单
遇到大面积 429,按这个顺序看,别乱:
- 单条最小请求能不能通?(区分账号/网络问题还是普遍限流)
- 当前并发多少?先降到 1 看还限不限。(判断是否并发超阈值)
- 读响应头
Retry-After、X-RateLimit-Remaining之类,确认剩余额度。 - 看官方状态页/社区,是否全局高峰期。
- 切闲时重试,或临时降级到 chat 模型。
收尾
限流不是 DeepSeek 的缺陷,而是共享服务的常态。会用的人把它当节奏器——被拒了退一步、抖一抖、错峰跑,系统反而更稳更省。核心就三句话:重试要退避加抖动、批量要限速错峰、关键路径要留降级。## 把限流应对做成标准件
团队里如果有多处调用 DeepSeek,别让每个人各写一套重试。把本文的退避、熔断、令牌桶封装成一个共享 SDK 或工具函数,统一版本、统一观测。这样限流策略一致,监控也能聚合,出问题一眼看出是哪条业务线在狂刷。标准化是规模化的前提:一个人写脚本可以随意,一个团队必须收敛,否则限流逻辑散落各处,调参和排障都成了噩梦。
写在监控看板上的三件事: 一是 429 发生率,超过 5% 就预警;二是平均退避等待,突然飙升说明在限流边缘;三是任务完成时长,错峰是否生效一目了然。数据说话,比拍脑袋判断稳。
再说一个容易被忽略的点: 限流阈值往往区分模型档位,reasoner 类推理模型通常比 chat 更紧。如果你大量跑推理任务,要么申请更高额度,要么把能降级的请求切回 chat。搞清楚自己账号在各模型上的实际限额,是制定限速策略的起点,别凭印象设并发,否则要么白白被限,要么额度闲置。
心态上的最后一句: 限流是共享服务的呼吸,不是针对你。顺着它、观测它、调优它,你的系统会比那些硬刚的人更稳更省。把节奏踩对,十万条任务也能安静跑完。
一点补充: 限流应对策略没有银弹,关键是「可观测 + 可调优」。先让系统把 429、等待、完成时长都记下来,再据此调并发和错峰,比背公式有用。观测到位,参数自然就准了,这才是工程化的正路。
把这篇的代码片段存进你的工具箱,下次再撞 429,你不会再慌,而是淡定地调一下并发、排个闲时、加个退避,让它自己跑完。