你有没有遇到过这种情况:DeepSeek 什么都会聊,但一问”我们公司的退款政策是什么”,它就瞎编。原因很简单——它没读过你的内部资料。要让模型”懂你家的事”,主流做法是 RAG(检索增强生成,Retrieval-Augmented Generation)。本篇讲清三种做法分别适合谁、要花多少代价。
一、先理解 RAG 在解决什么问题
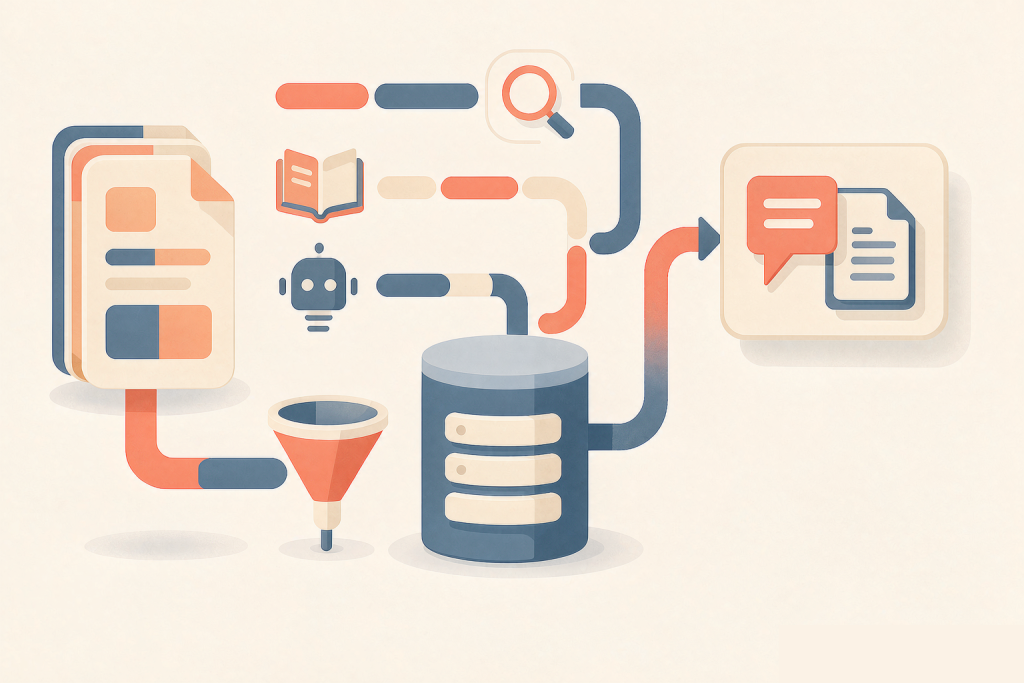
RAG 的核心思路是:先根据用户问题,从你的文档里找出最相关的几段,再把”问题 + 找出的资料”一起发给模型,让它基于资料作答。这样模型就不用”凭记忆硬猜”,答案能落到你给的原文上。
为什么不直接把文档全塞进提示词?因为文档可能几万字、几百份,而模型一次能处理的量有限,且越长越容易”读到后面忘了前面”。RAG 的本质,是用检索把最相关的那一小块精准投喂给模型。
二、做法一:直接灌进长上下文
最简单粗暴的方式是——利用 DeepSeek 支持的长上下文能力,把文档整段贴进对话,直接问。
- 适用场景:文档就一份、几万字以内、偶尔问一两次。比如分析一份合同、读一篇长论文。
- 优点:零搭建成本,复制粘贴就能用,最贴近”新手友好”。
- 代价:每次都要重新贴全文,费 token、费钱;文档一多就管不过来;无法自动”找重点”。
适合个人临时任务,不适合做成长期服务。
三、做法二:本地搭向量数据库
这是开发者最常用的”正经”方案。流程分三步:
- 切片:把文档拆成小段(如每 500 字一段)。
- 向量化:用嵌入模型把每段变成一串数字(向量),存进向量数据库(如 Chroma、FAISS、Milvus)。
- 检索 + 问答:用户提问时,先把问题也转成向量,去库里找最相近的几段,连同问题发给 DeepSeek 生成答案。
- 适用场景:文档量大、需要长期、私有、可离线的知识库;对数据隐私要求高的企业。
- 优点:检索精准、可扩展、数据留在自己机器上。
- 代价:要写代码、维护数据库和服务;嵌入模型与向量库本身有学习和运维成本;需要一台能跑的服务器或本机。
下面是一个最小可用的检索片段示意(伪代码思路,真实项目请用成熟库):
# 思路示意,非完整工程代码
chunks = split_document("手册.pdf")          # 1. 切片
vectors = embed_model.encode(chunks)         # 2. 向量化
db.add(vectors, chunks)                      # 3. 入库

query_vec = embed_model.encode("退款政策?")  # 提问也向量化
top = db.search(query_vec, k=3)              # 取最相关 3 段
answer = deepseek.chat(top + "请根据以上资料回答:" + question)
四、做法三:用平台托管知识库
如果你不想自己搭服务器、写检索代码,可以直接用现成的托管平台——把文档上传进去,平台帮你切片、建索引、接好模型,你只管提问。
- 适用场景:没有开发团队、想快速上线客服/内部问答的中小团队;要的是”开箱即用”。
- 优点:几乎零运维,上传文档就能用,通常自带权限管理和界面。
- 代价:数据要交给第三方平台,需评估隐私合规;按用量或套餐计费,具体以对应平台当前报价为准;灵活性不如自己搭。
五、三种做法对比表
| 维度 | 直接灌长上下文 | 本地向量库 | 平台托管知识库 |
|---|---|---|---|
| 上手难度 | 极低(复制粘贴) | 高(需写代码) | 低(上传即用) |
| 适合文档量 | 单份/少量 | 大量/持续更新 | 中大量 |
| 数据隐私 | 走官方接口 | 完全自管 | 依赖平台方 |
| 运维成本 | 无 | 高(服务器+代码) | 低 |
| 检索精度 | 无检索,靠全文 | 高 | 中高 |
| 费用特点 | 按 token 计,以官方为准 | 算力+存储成本 | 套餐/按量,以平台为准 |
| 典型用户 | 个人临时任务 | 企业/开发者 | 中小团队 |
六、该怎么选:一张决策清单
- 只想让模型读一份合同或论文 → 做法一,直接贴。
- 你公司有几百份手册、要 7×24 自动答疑且数据不能出内网 → 做法二,本地向量库。
- 你是小团队,没工程师,但想下周就上线一个产品问答机器人 → 做法三,托管平台。
RAG 不是越复杂越好,而是”匹配你的体量和能力”。新手建议从做法一体验感觉,再视需求升级。
小结
RAG 就是把”检索”和”生成”拼起来:先找资料,再让 DeepSeek 基于资料作答。三种做法没有绝对优劣,只有合不合适——临时用就灌上下文,要私有可控就本地向量库,想省事就上托管平台。下一篇我们看看,这些能力在手机上又能怎么用。